销售热线
主营:欧姆龙,三菱,安川,Pro-face,松下
AI 视觉在工厂里,最早做缺陷检测,后来能做装配检查,现在又能做 SOP 监控;再加上扫码、定位这些常规任务——如果都能做,是不是就能覆盖整个工厂的视觉?10 月 27 日,我在 VisionChina 深圳展研讨会上的演讲就围绕这个问题展开。这篇文章把演讲整理成文,补上现场来不及展开的算账过程与项目素材。
我的回答是:能,但要三个条件同时成立——视觉大模型做到少样本、强泛化;视觉智能体做到通用、易用、快速交付;部署方式是边缘部署,一拖多、非常多,创造性价比。缺了哪一条,整厂视觉要么做不起来,要么铺不开。还有一块现在没做好——成像,放在文末讲。
演讲 01演讲数字人播报版,11 分 14 秒,片尾为主持人点评。讲稿依据现场演讲整理精修,去掉重复与口头语,数据与案例不变;配音以崔忠伟本人录音为音色参考合成,并非现场逐字原声。
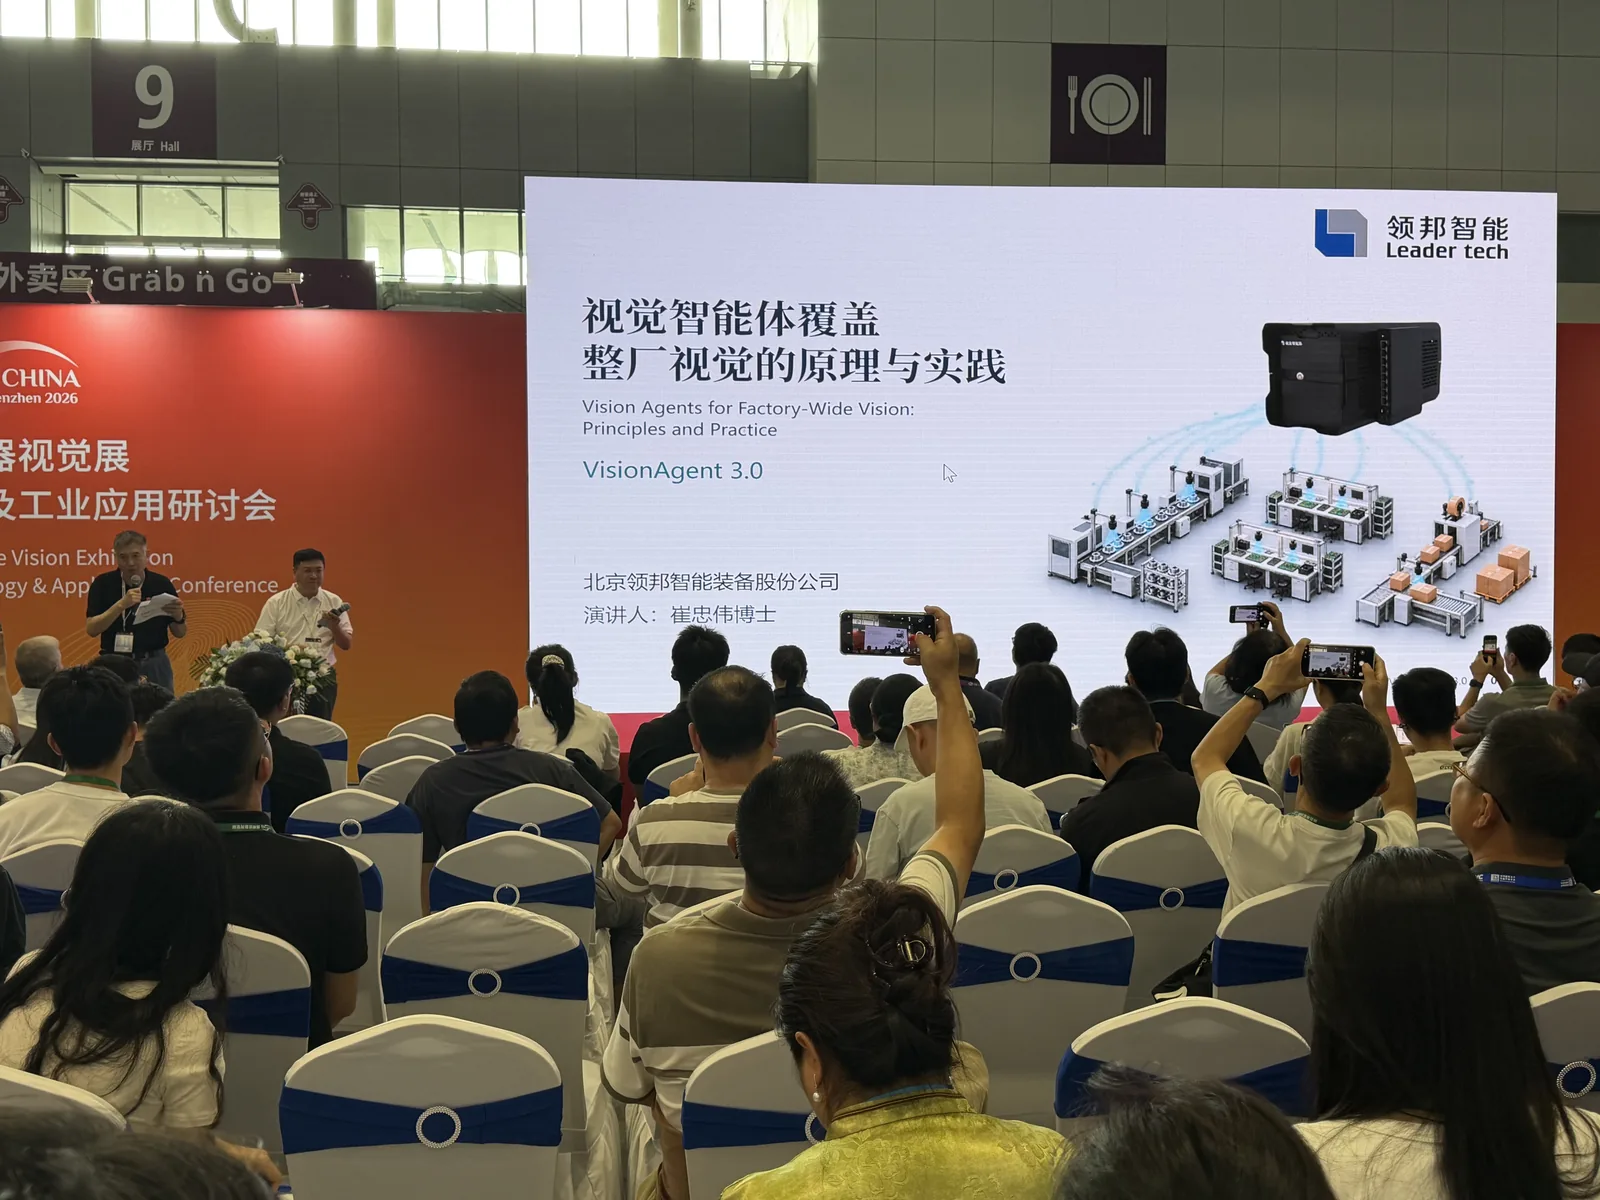
现场 01演讲现场,2026 年 10 月 27 日,大屏上为本次演讲首页。
问题
整厂视觉,到底要看什么
一座工厂里的视觉任务大致三类:检查产品缺陷、核对装配状态、监控作业过程是否符合 SOP;另有扫码、定位这类常规任务。过去它们往往分属不同设备、不同供应商:外观检测一套,装配防错一套,SOP 监控再一套;换一个 SKU,就要重新收样本、重新调程序。
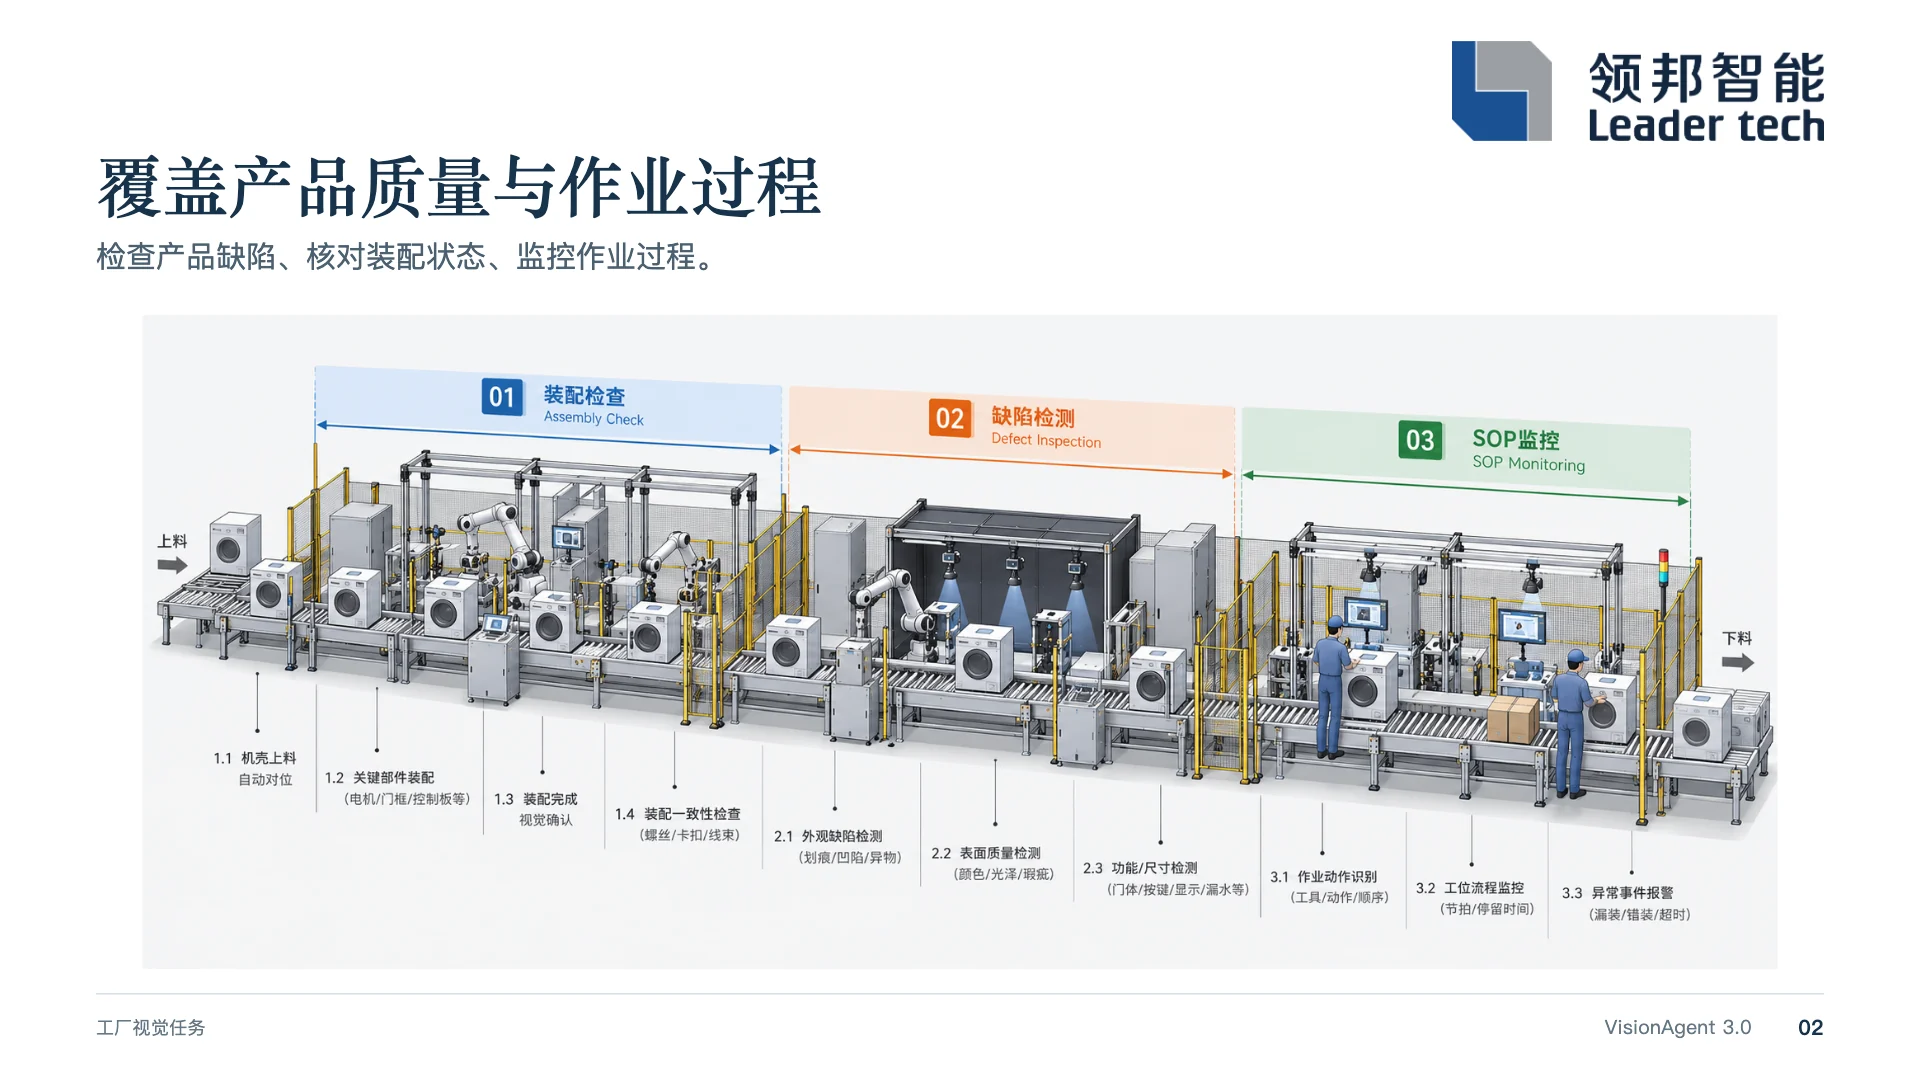
示意 01工厂视觉任务:同一条线上,缺陷检测、装配检查与 SOP 监控分布在不同工位。演讲第 2 页。
要用一套东西覆盖它们,技术路径得同时回答两件事:一是好不好用——一个模型能否通吃三类任务,换型时是否还要从头收样本;二是贵不贵——能否便宜到整厂铺开,而不是只做一两个试点。下面的内容,都是在回答这两件事。
产品形态
两种形态:边缘智能体与本地智能体
视觉智能体有两种产品形态,大部分能力相同,区别在集成方式。

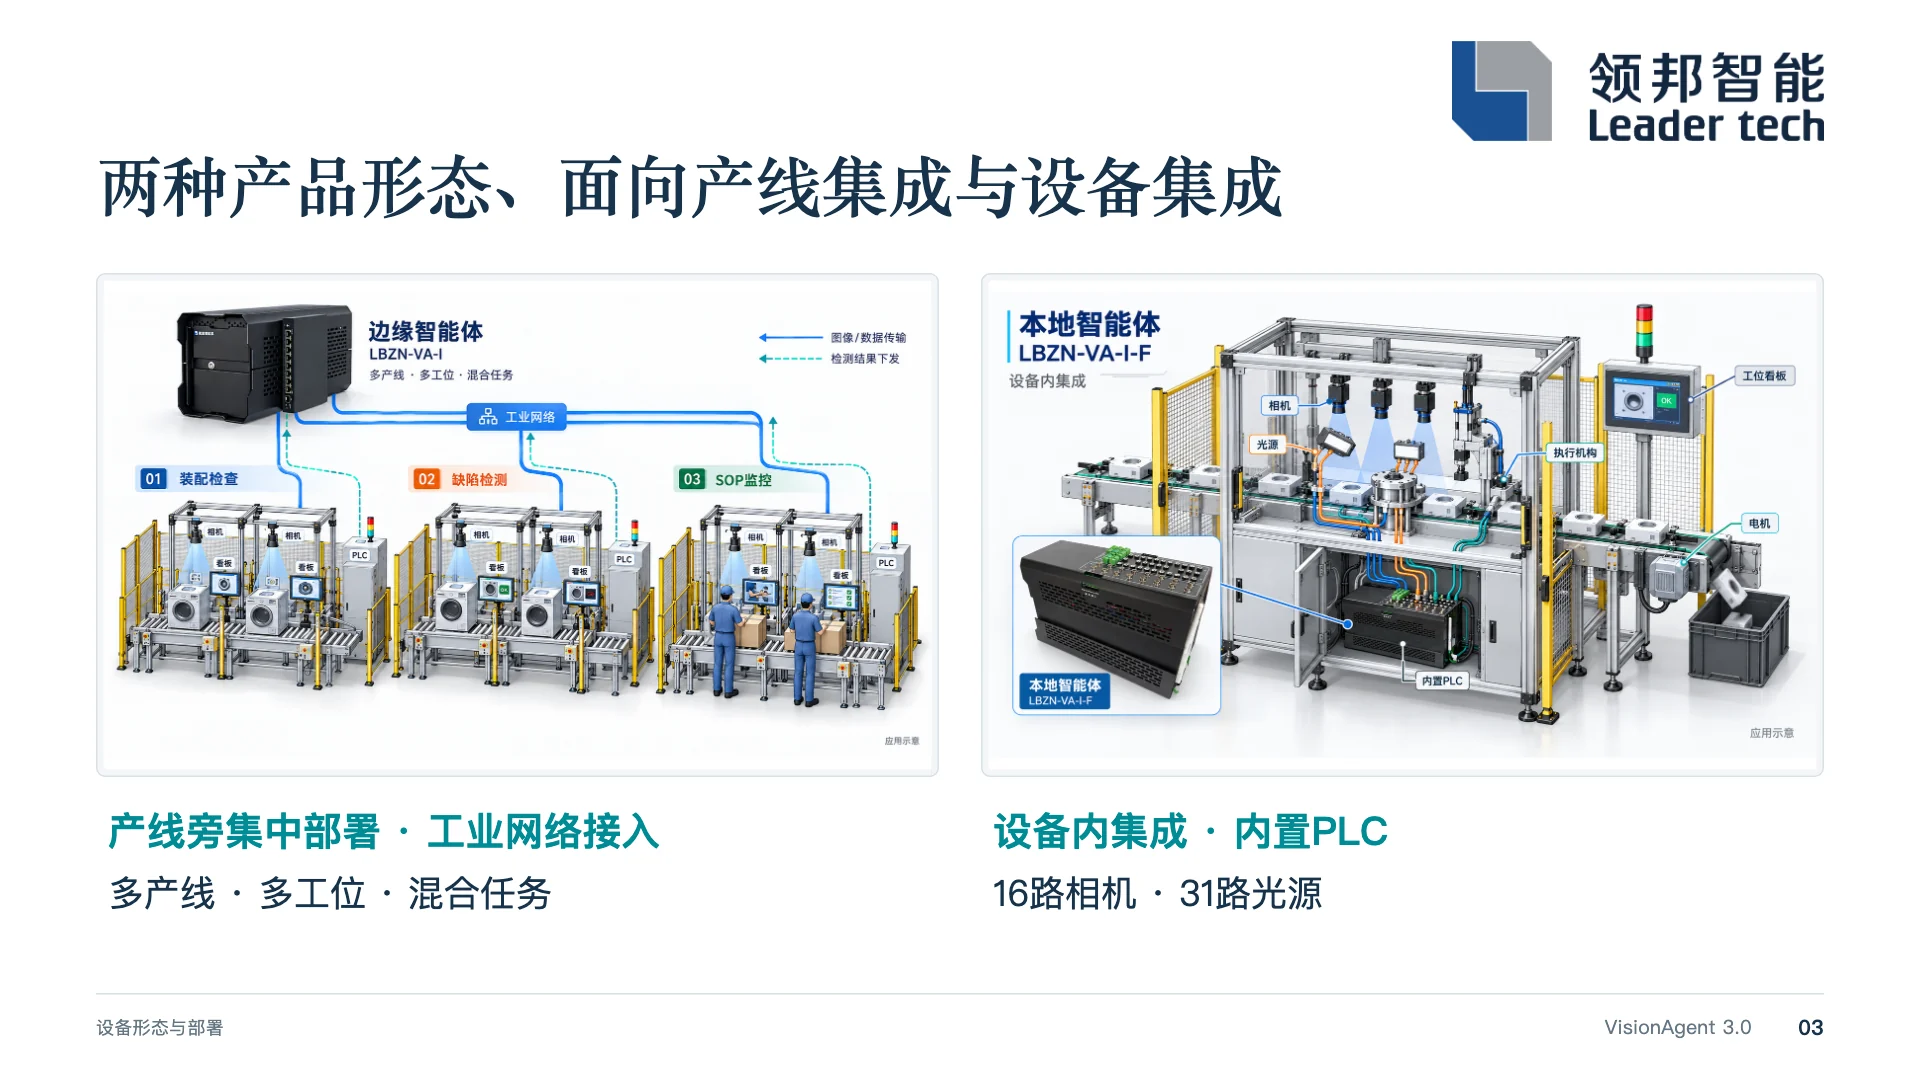
设备 01两种产品形态。左:边缘智能体,产线旁集中部署、工业网络接入;右:本地智能体,设备内集成、内置 PLC。演讲第 3 页。
整厂覆盖主要靠边缘智能体,下文都以它为主。
边缘部署
为什么是边缘:既不在端侧,也不在云侧
卷积时代,模型靠大量样本训练,训练往往依赖云侧或专门的训练服务器。视觉大模型是预训练的,到现场只需少量样本微调,训练在边缘就能完成——推理和训练合在同一台设备上,即推训一体。这是边缘部署成立的第一个前提。
第二个前提是网络。边缘与端之间用的就是传统工业以太网:相机图像直接送进智能体,处理结果再送回端上的看板、PLC 和报警灯。铜缆以太网单段最长 100 米,更远就在中间加光纤,所以生产线不管多长,纵向跨工位、横向跨产线都能接进同一台。
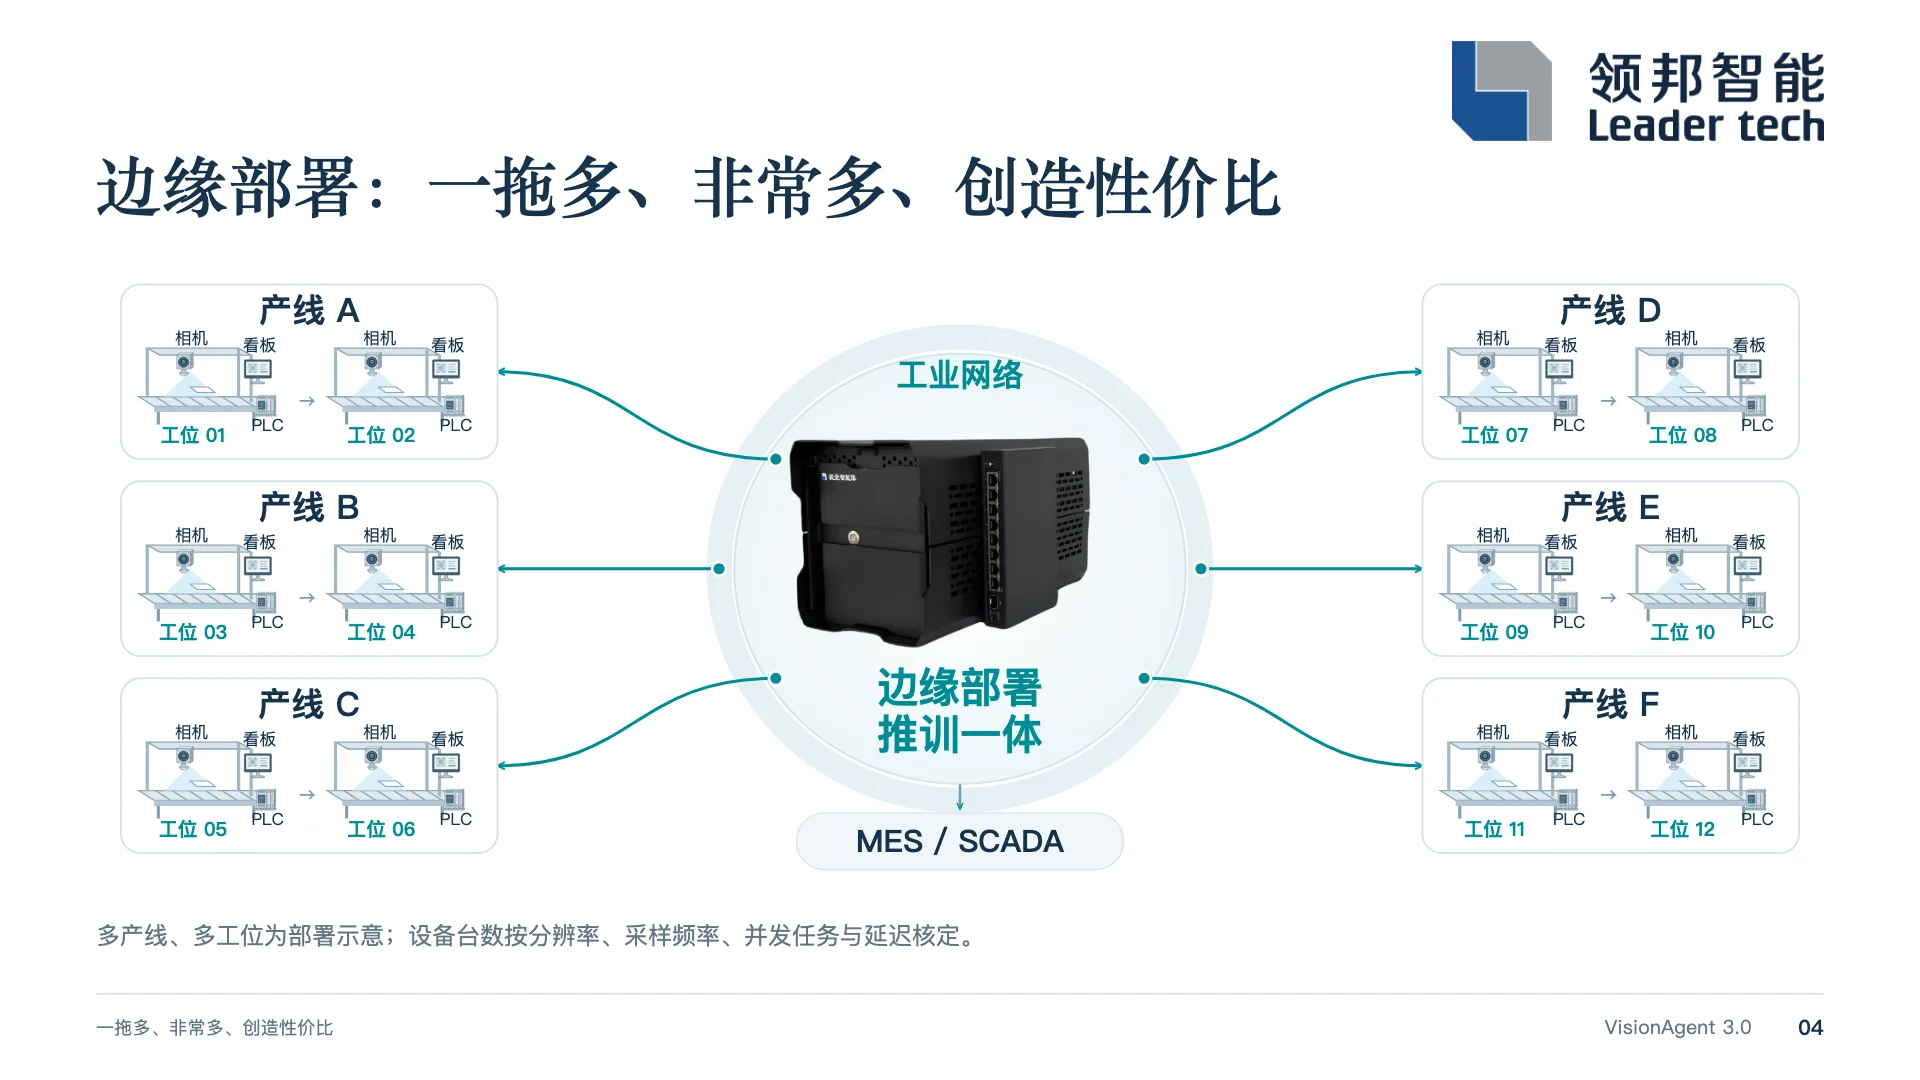
示意 02边缘部署:一台推训一体的边缘设备上连 MES/SCADA,下连多条产线的工位。图中产线与工位数量为示意,设备台数按分辨率、采样频率、并发任务与延迟核定。演讲第 4 页。
往上,边缘连 MES 或 SCADA:MES 下发配方,告诉它当前是哪个 SKU、哪个机种,它就完成切换。往下,每个工位至少一台相机取图;有工人的工位配一块看板,提示哪一步做错、提醒重做;需要分流或剔除的工位,再加 PLC 与执行机构。这些就是端侧资源。
端侧一拖一的两种极端
为什么不把算力放在端上?一拖一时只会出现两种极端:只接一台相机,算力用不完;接到十台相机,又带不动。GPU 目前仍是贵资源,按峰值给每个工位单配一份,大部分时间在闲置。

示意 03逐站预留与错峰共用:A、B、C 三站的计算任务在同一时间轴上错开执行,合并后少了各站为峰值单独预留的闲置窗口。概念示例,不代表实际容量或实测耗时。

示意 04平台与共性能力的投入 F 由 N 个工位分摊。不表示各工位的现场工程成本也按 F/N 下降。
能拖多少,要算吞吐账
“一拖多”能拖多少,不是口号,而是按图像尺寸、推理吞吐和节拍算出来的。以餐盘项目为例(完整推导见 《一拖多、非常多》):识别输入为 700×700 切片,设备推理吞吐按 200 张/秒计,现场 20 秒一个采集周期;每台 4K 线阵相机每周期折合一帧 4096×4096,按 700 切片横竖各切 6 刀,共 36 张。
4000 张每周期推理预算:200 张/秒 × 20 秒
2880 张80 台相机每周期实耗:80 × 36,占预算 72%
22 条线单台上限:⌊4000 / 36⌋ = 111 路相机,按每线 5 台取整
现场停在 16 条线,留出 28% 的余量给补拍复核、新品试跑和后续加线。东西再好,太贵也只能做试点、铺不开;从性价比看,边缘部署最合适——一拖多、非常多,创造性价比。
通用
通用:一个基础模型,管缺陷、装配和 SOP
视觉智能体的核心是视觉检测大模型——基于 Transformer 的基础模型,而不是卷积网络。差别首先落在样本上。
卷积模型需要大量样本:一个工位往往要收集上千张。一拖多之后,工位成倍增加,SKU 还有十几个、二十多个——粗算一下,20 个工位、每个工位 20 个 SKU、每组上千张,就是 40 万张量级的采集与标注,部署非常困难,成本也非常高。预训练的基础模型针对具体 SKU,每个缺陷或目标只要 1–5 张样本。

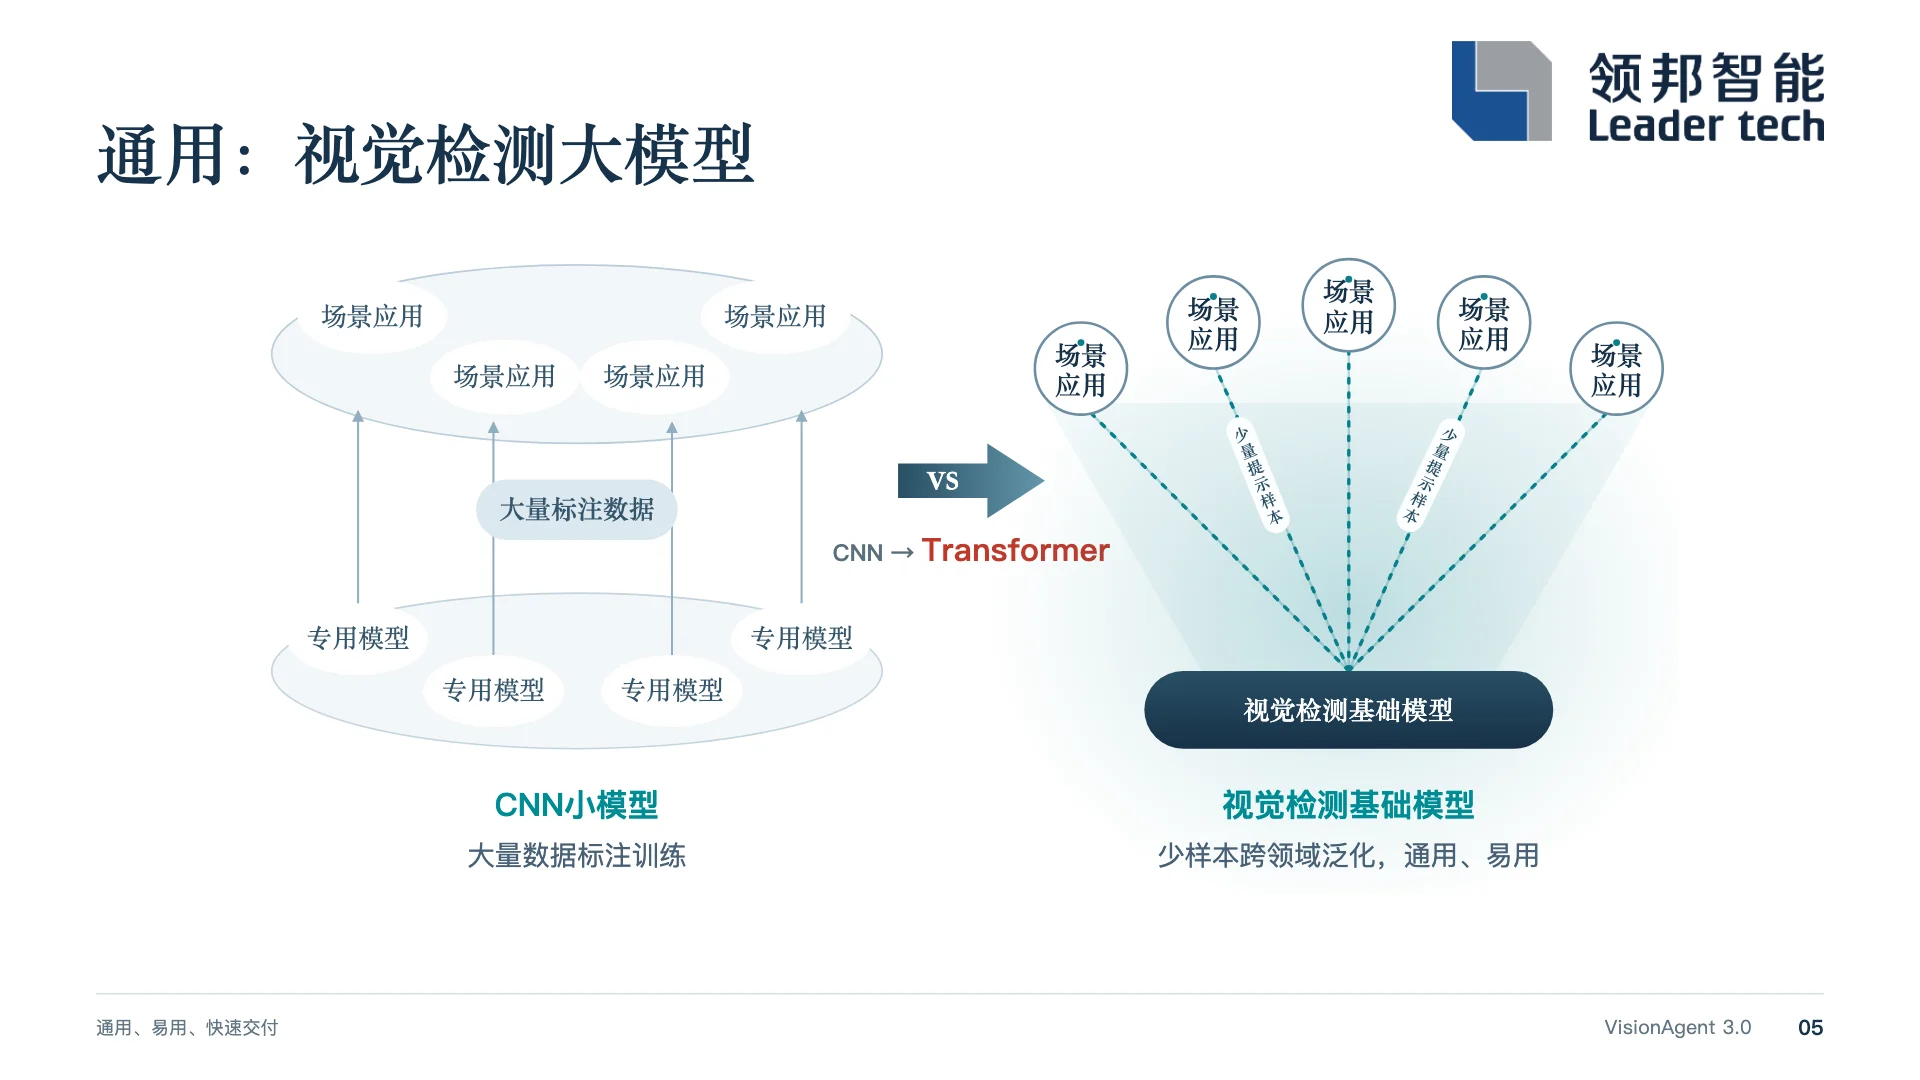
示意 05CNN 小模型与视觉检测基础模型:前者每个场景一个专用模型、依赖大量标注数据;后者以少样本跨领域泛化。演讲第 5 页。
它不是为某个领域专门训练的:缺陷检测可以,装配检查——俗称的错漏反——可以,SOP 也可以。模型只有一种输出形式,就是像素级语义分割,没有方框检测之类的分支。原因是像素分割最通用:缺陷是一片区域,零件是一块轮廓,工人的手和工具也是轮廓,都能用同一种表达,再交给事件和状态机去判断。
还要分清一点。用大模型生成缺陷图片给卷积小模型补样本,或用大语言模型给设备做交互界面,都在检测流程之外,是辅助。这里说的大模型在检测流程之内,直接出判定;它需要的样本本来就少,也用不着生成数据来补。
易用
易用:拖拉拽编排,算子少而大
现场配置不写代码:从算子库把算子拖到画布,连上线,再为节点指定相机、模型和输出对象,一条工作流就搭好了。和过去的拖拉拽工具相比,有两点不同:一是界面做得干净;二是算子高度抽象、数量很少。
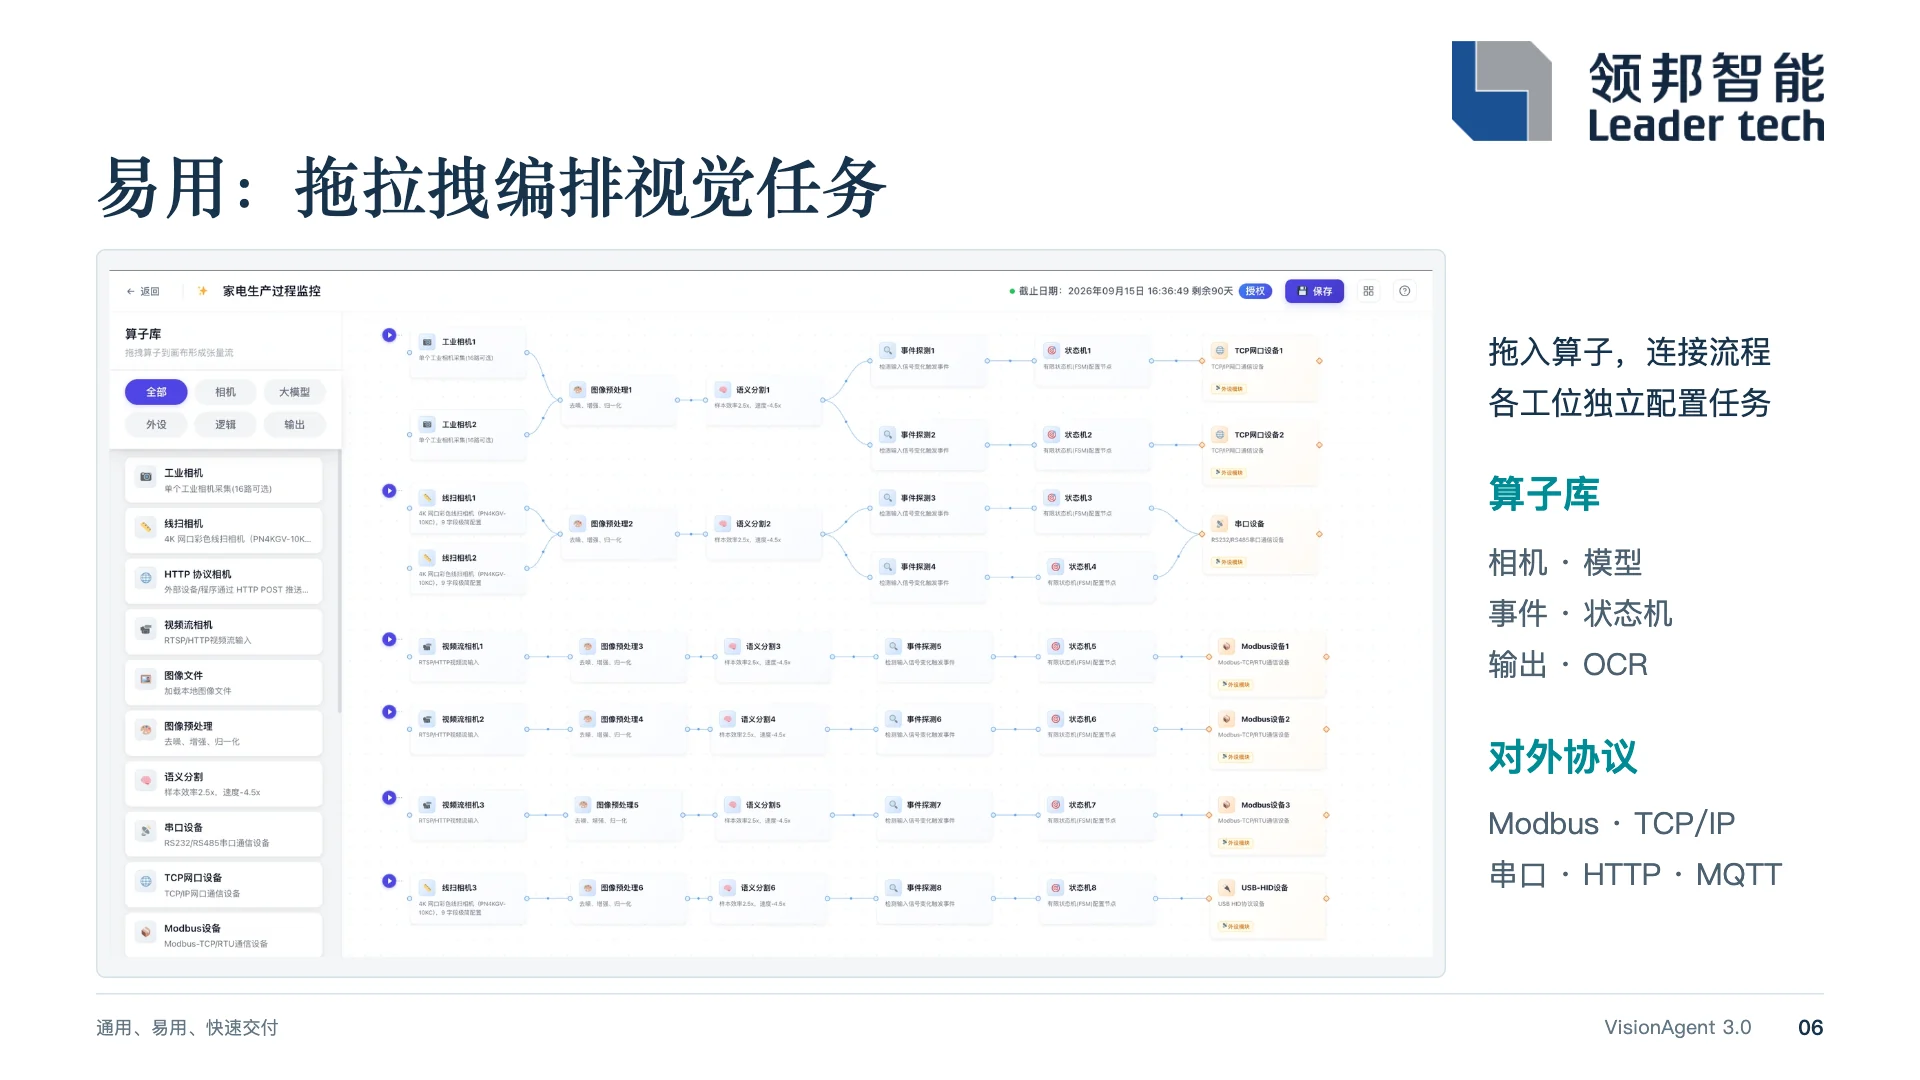
界面 01拖拉拽编排:拖入算子、连接流程,各工位独立配置任务;右侧为算子库与对外协议。演讲第 6 页。
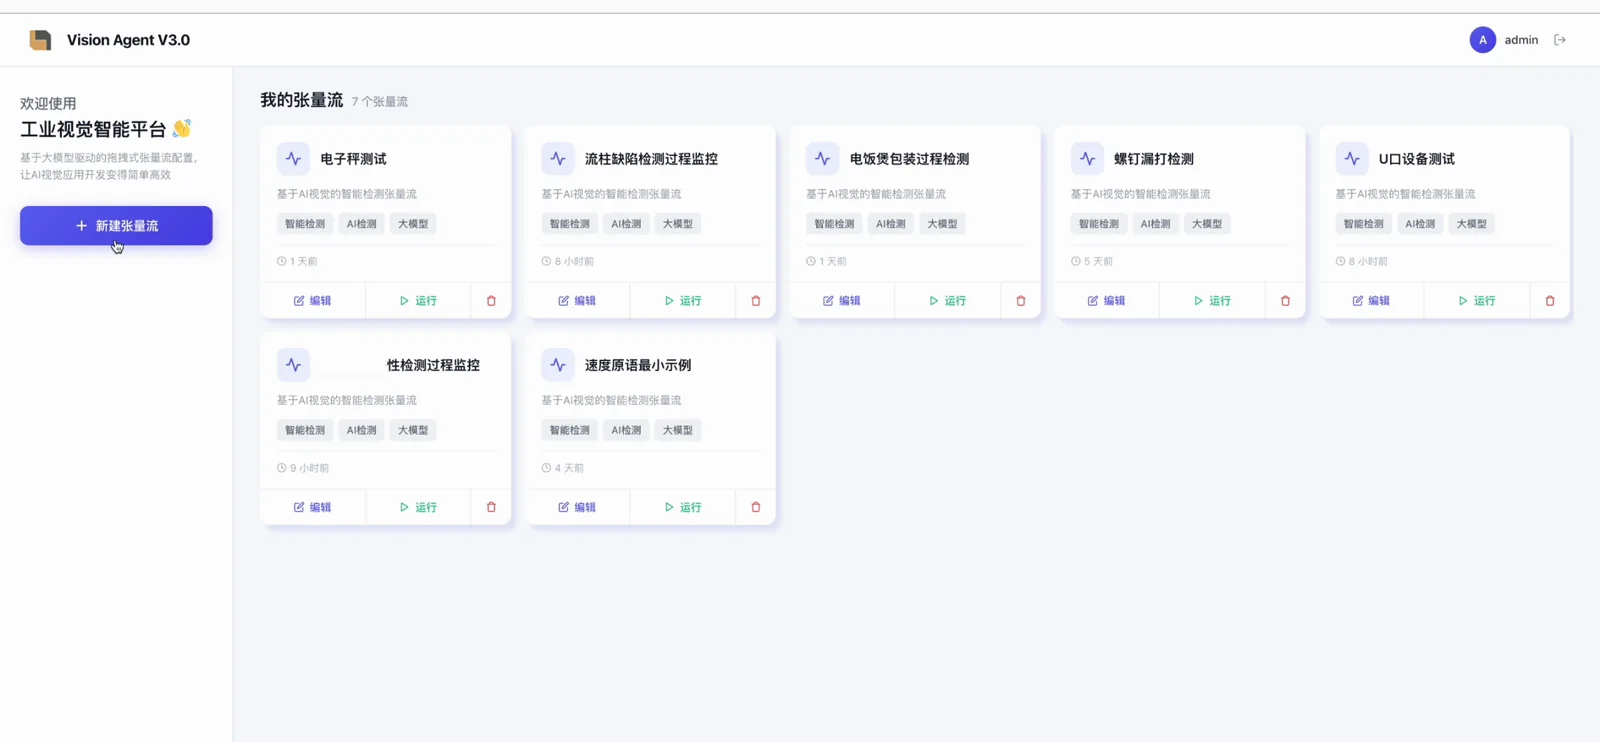
界面 02“我的张量流”列表:同一平台上并列管理多条工作流,对应不同工位与任务。
缺陷检测、装配检查、SOP 监控用的是同一条算子链,差别只在模型类别、事件定义和状态机——这也是同一台智能体能并行跑三类任务的原因。